- 形态
- Android · 鸿蒙 · 浏览器 / PWA
- 识别
- 端侧离线,sherpa-onnx
- 复习
- FSRS-4.5 间隔调度
- 内容
- 中医经典 8 部 1581 条 + 古诗 33 首
它是什么
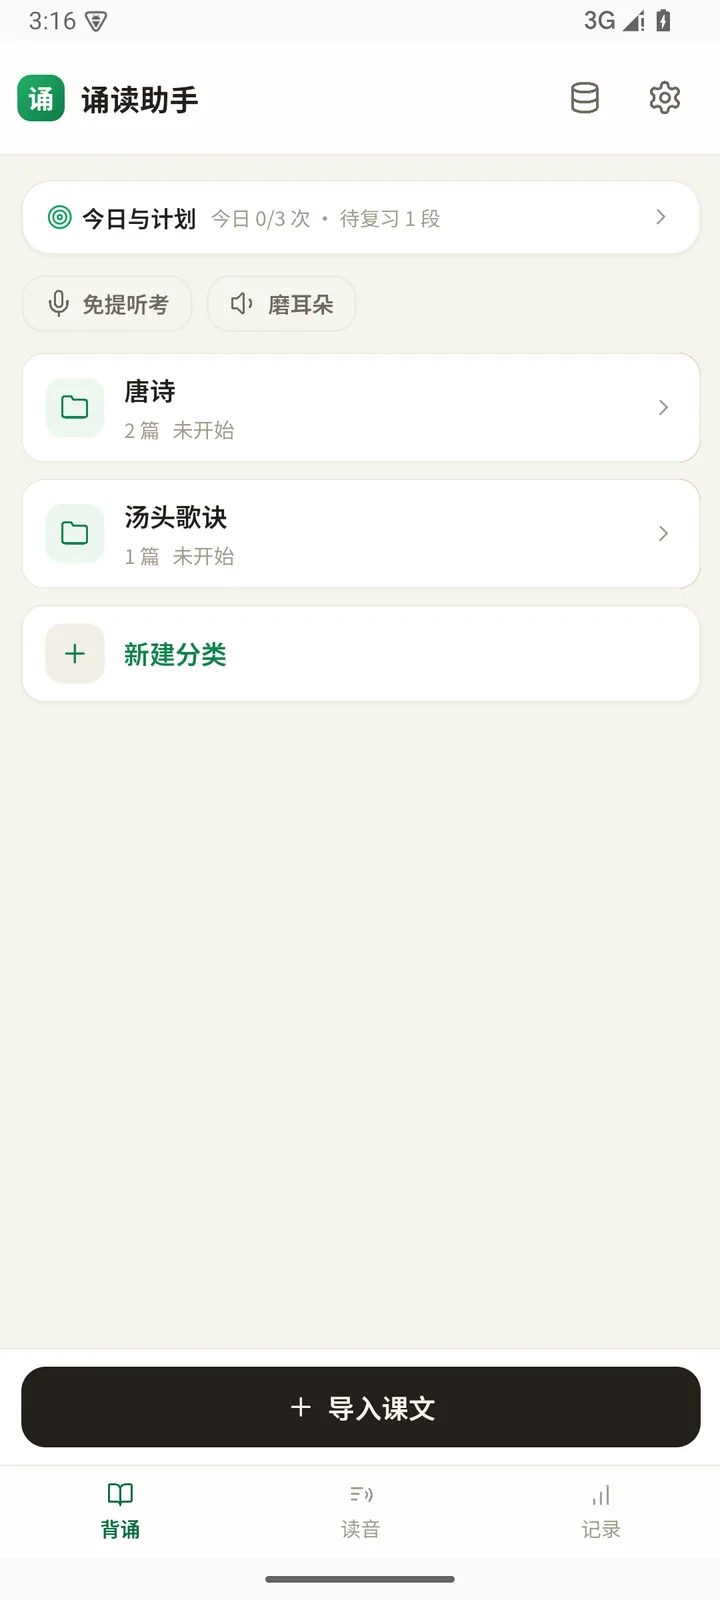
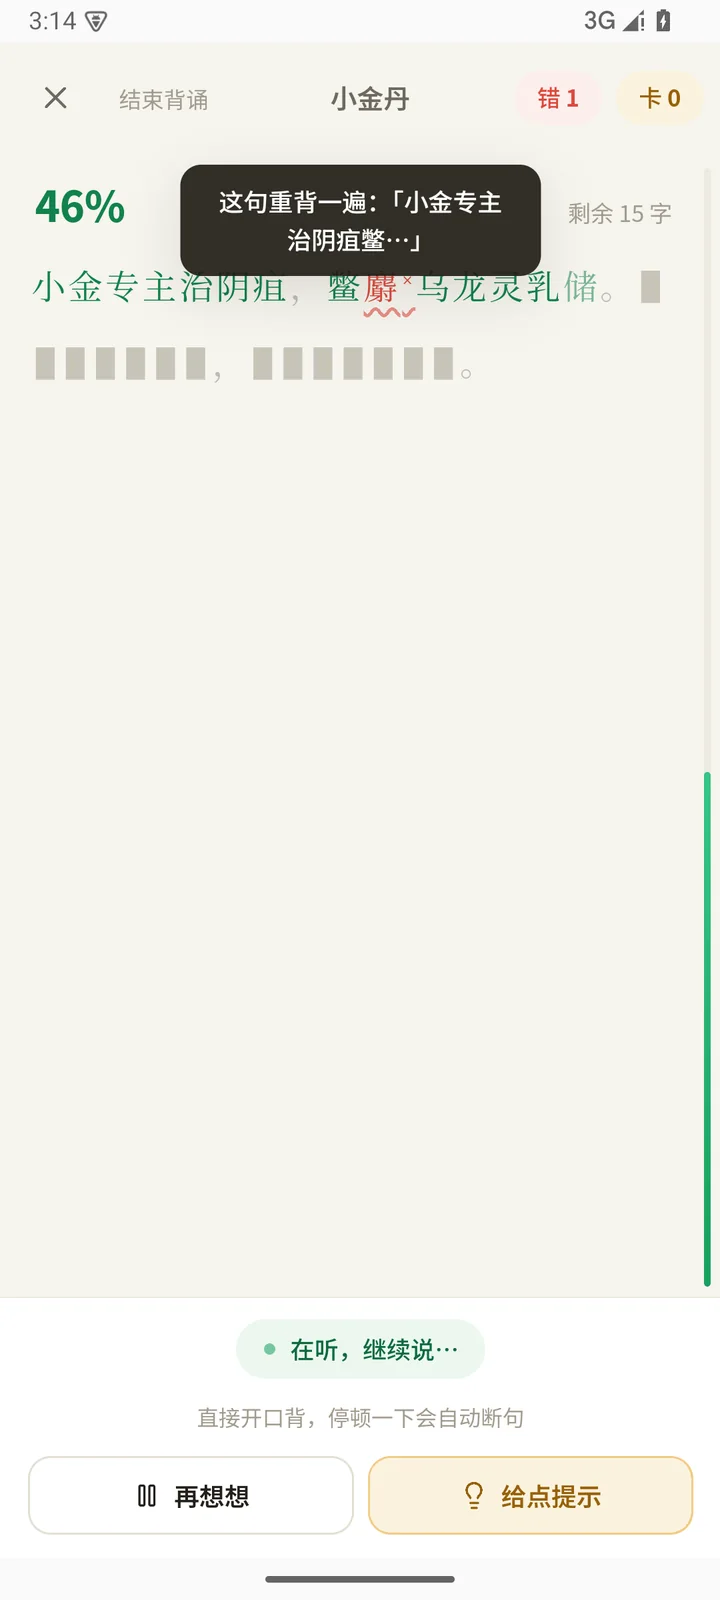
一个模拟「找老师背课文」的背诵助手。打开课文直接开口背,每停顿一句,它把识别结果和原文做一次对齐,告诉你背到哪了、哪几个字错了、哪一句卡住了。背错的地方标红,语音会轻声提醒「应该是 X」。
背诵只是七环里的第三环。前后还有:定目标、熟读、连背、检测、间隔复习、长期保持。每一环都有对应的实体功能,不是列在规划里的空壳——背完之后要复习什么、什么时候复习,由 FSRS 按你的实际表现算,而不是按「第 1 天、第 2 天、第 4 天」这种死表。
进度只进不退。背错照记、照标红、照提示,但不把你拽回句首重新来过。
「错句自动重背」这个看起来很合理的设计,实测反而伤体验:光标被拽回句首、已经背出来的字重新遮住,一次识别抖动会被记成两条错误。现在它默认关闭,真想补背直接点那段红字,次数不限。
功能
边说边判
实时流出字幕,停顿后由精度模型对整段重新解码打分。两层模型:25 MB 内置模型负责即时反馈,167 MB 精度模型负责最终判定。
六级提示阶梯
L0 口诀锚点 → L1 上一句回放 → L2 再揭一个字 → L3 揭到设定字数 → L4 半句 → L5 整句。卡住时逐级放开,不一下给答案。
四种背法
整篇、分段、挖空(浅 20% / 中 35% / 深 50%)、领读跟读。挖空位置按历史弱点优先,也可以随机。
五种考核
键盘默写逐字判分、考官模式双人逐句、免提听考不看屏幕、条号双向考核(给号背文 / 给文写号)、限时随机抽段。
今日复习
到期段落排队,题型轮转,开口先念出处与上下文,上次的错点会重放。评分可四键人工覆盖,也可跳过顺延一天。
中医经典库
伤寒论精选 119、金匮要略 469、汤头歌诀 312、药性歌括四百味 445、药性赋 130、濒湖脉学 78、灵枢·经脉、经络歌诀,共 1581 条,带条号与章节。
磨耳朵与播放条
播放今日到期段与近七天错点段,遍数、间隔、连播、定时关闭可调;通知栏与锁屏有播放控制,息屏也能听。
看得见的长期变化
掌握度衰减预警、记忆画像、14 条成就、打卡日历、易错字本(同音 / 近音 / 漏字 / 其他四类),可导出字帖与阶段证书。
为什么坚持在端侧跑
语音识别和语音合成默认全部在手机本地完成,零网络、零费用、不上传。这不只是隐私姿态:背诵是每天都要做的事,如果每次开口都要等网络、算 token、担心余额,它就不可能被坚持下去。
云端识别作为可选项保留(自带密钥、默认关闭),但绝不静默降级到收费通道。端侧失败会明确告诉你失败,而不是偷偷替你花钱。
判定这件事有多难
识别结果不是干净的文本:有口音、有回读、有「那个」「就是」这类填充词,还有识别引擎自己听错的时候。如果逐字硬比,用户会被大量误判逼疯。
所以判定层做了两阶段窗口的 DP 对齐,再加一串「宁可放过,不可冤枉」的提交门控:口语折叠、填充词剔除、回读前缀摘除、垃圾前缀救援、跨段重复识别检测、单字残音守卫、防乱串远跳。真正的硬错误才记账,边界情况走软纠偏。
这些规则不是拍脑袋写的,是二十多轮真机实测、逐条回放日志之后留下来的。每条规则背后都有一次具体的误判案例,也都有对应的回归测试。
数据不会丢
四层防丢:每天、每个会话、导入前、删除前自动拍快照(环形保留七份);删掉的课文进回收站,保留五十条、三十天;支持全量 JSON 导出与合并导入;超过三天没备份会提醒。
这一层是踩过坑才补上的:早期版本里复习进度和复习日志因为键名映射写错,一直没有真正落库,重启就消失。现在的守护方式是「换一个数据库实例读同一份库」——表面上一切正常的数据,必须经得起再打开一次。